
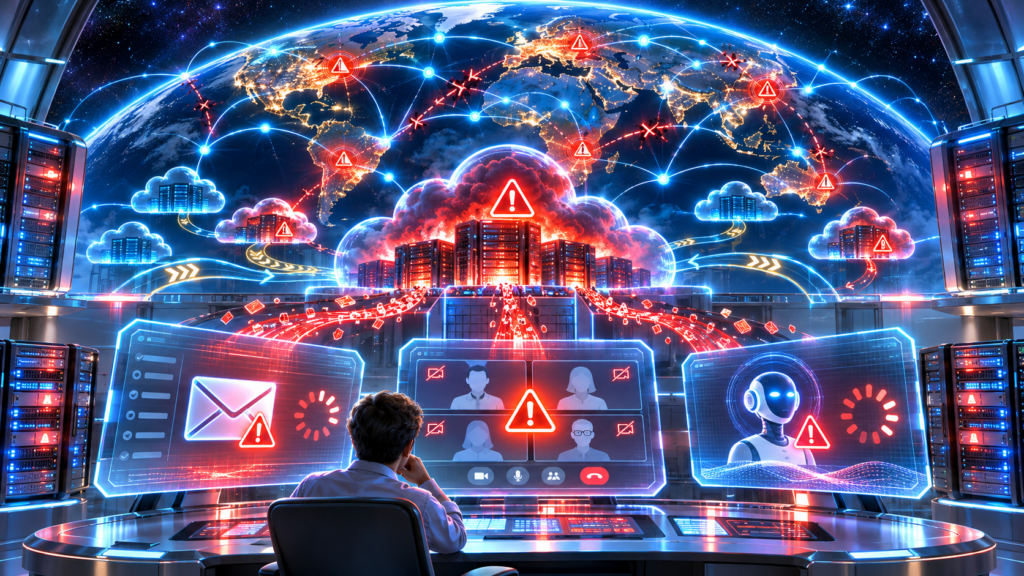
A partire dal pomeriggio di giovedì 12 novembre 2026, l’intera architettura digitale su cui si basa il lavoro moderno ha smesso di funzionare, trascinando nel caos milioni di lavoratori a causa di un disservizio globale senza precedenti. Le prime avvisaglie si sono registrate quando gli utenti hanno iniziato a inondare i centralini di assistenza lamentando l’impossibilità di accedere alle proprie caselle di posta elettronica. In poche ore, i problemi a Outlook si sono estesi a macchia d’olio, colpendo oltre settanta nazioni e rendendo inutilizzabili strumenti fondamentali per lo smart working e la collaborazione a distanza. L’impossibilità di avviare riunioni su Microsoft Teams o di sfruttare le nuove funzionalità di intelligenza artificiale integrata ha certificato la gravità della situazione. I pannelli di monitoraggio ufficiali hanno confermato l’apertura di incidenti critici, dimostrando che non si trattava di un’anomalia locale, ma di un collasso che ha coinvolto l’intero ecosistema cloud dell’azienda di Redmond, costringendo il mondo intero a una pausa forzata.
Le vere cause dietro il crollo dei server di Redmond
Fin dai primi minuti del blocco, la paura di un attacco hacker su vasta scala ha iniziato a serpeggiare tra gli addetti ai lavori. Tuttavia, le dichiarazioni ufficiali hanno categoricamente smentito l’ipotesi di un’intrusione informatica o di una sottrazione di dati sensibili. La vera causa del Microsoft 365 down è da ricercarsi in un clamoroso fallimento interno dei sistemi di bilanciamento del traffico di rete. Le ricostruzioni tecniche fornite dagli sviluppatori indicano che un gruppo cruciale di server è diventato improvvisamente irraggiungibile. Questo evento ha innescato un effetto domino devastante, riversando un carico di richieste anomalo e insostenibile sull’infrastruttura rimanente, generando inevitabili e continui errori di connessione. Nel tentativo disperato di fermare l’emorragia, gli ingegneri informatici hanno bloccato tutte le implementazioni di codice in corso e hanno provato a deviare il traffico globale verso nodi di rete più stabili. Purtroppo, i sistemi automatizzati di controllo della salute dei server hanno continuato a registrare anomalie, costringendo i tecnici a faticosi riavvii manuali che hanno allungato drasticamente i tempi di reazione.
Le conseguenze sulle comunicazioni aziendali e pubbliche
Le ripercussioni di questo prolungato blocco informatico si stanno rivelando drammatiche per il tessuto produttivo internazionale. Dalle agenzie governative in Nord America e in Asia, fino alle multinazionali europee, la paralisi operativa è quasi totale. Diverse compagnie aeree internazionali si sono trovate nell’impossibilità di gestire le comunicazioni interne, avvertendo i passeggeri di potenziali ritardi nei voli. Anche il settore bancario e quello finanziario hanno subito pesanti battute d’arresto, impossibilitati a scambiare report e documenti riservati a causa dell’inaccessibilità dei servizi di archiviazione condivisa. Il nodo più critico resta però la gestione della posta elettronica, il cuore pulsante delle interazioni lavorative. Per scongiurare la perdita definitiva dei messaggi inviati durante la crisi e rimasti bloccati nella rete, l’azienda ha applicato una misura di sicurezza straordinaria, estendendo il timeout di Exchange Online a quarantotto ore. Grazie a questa mossa, le email in sospeso rimarranno parcheggiate in code di attesa sicure, per poi essere smistate gradualmente verso i legittimi destinatari non appena l’emergenza rientrerà.
I comportamenti da evitare durante l’emergenza digitale
Quando si verifica un malfunzionamento di Copilot e delle suite di produttività così vasto, il panico porta spesso gli utenti a compiere operazioni che possono compromettere ulteriormente i propri dispositivi. Gli analisti di sicurezza informatica sottolineano l’importanza di mantenere la calma, sconsigliando vivamente di disinstallare i pacchetti software dal proprio computer o di cancellare i profili di posta elettronica. Rimuovere le credenziali o tentare di riconfigurare i server in ingresso e in uscita non servirà ad accelerare il processo, poiché il guasto è interamente centralizzato nei data center americani. La strategia di sopravvivenza più saggia consiste nel recuperare, laddove possibile, i file salvati in locale sul disco rigido prima dell’inizio del blackout e nell’utilizzare temporaneamente canali telefonici o piattaforme di videoconferenza di aziende concorrenti per portare a termine le mansioni più urgenti della giornata.
Le tempistiche di ripristino e le sfide del cloud computing
Con il passare delle ore, questo down mondiale si sta configurando come una delle sfide tecnologiche più complesse mai affrontate dal gigante dei software. Sebbene gli ultimi bollettini tecnici segnalino leggeri e progressivi miglioramenti nella stabilizzazione delle connessioni, manca ancora una stima precisa per la totale risoluzione della problematica. Le squadre di emergenza stanno lavorando senza sosta per implementare nuovi sistemi di mitigazione in grado di rilevare e correggere autonomamente i nodi di rete danneggiati. L’obiettivo primario è fare in modo che l’architettura resista all’onda d’urto del traffico nel momento in cui milioni di account cercheranno di riconnettersi simultaneamente. Questa crisi profonda sta sollevando interrogativi importanti sulla resilienza delle infrastrutture centralizzate, ricordando al mondo intero quanto l’affidamento totale a un singolo fornitore di servizi cloud possa trasformarsi, in giornate come questa, nel vero tallone d’Achille della nostra società interconnessa.
 Vuoi ricevere le notifiche sulle nostre notizie più importanti?
