
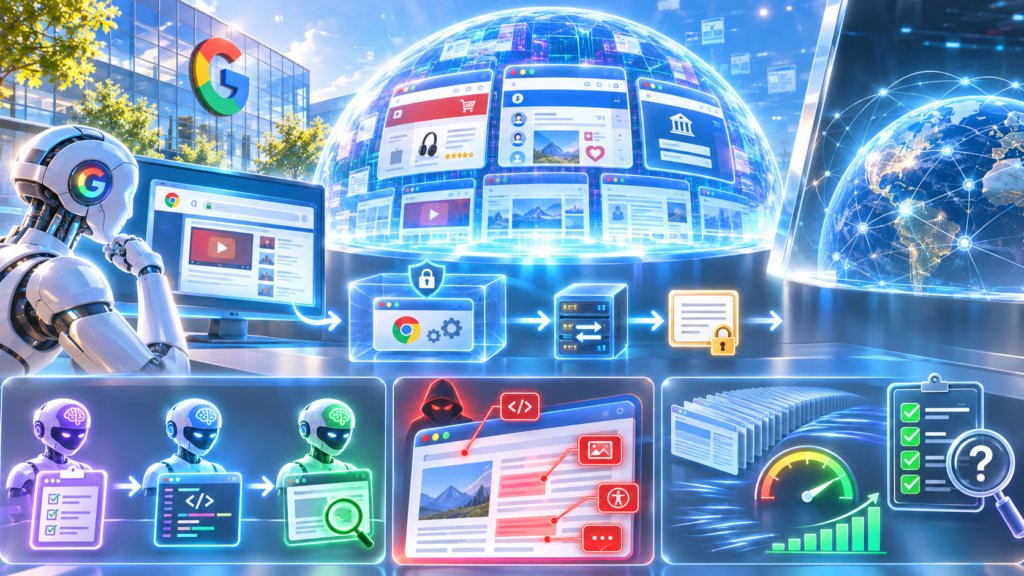
Secondo le recenti notizie diffuse riguardo ai progetti interni di Alphabet, il team di sviluppo di Google Chrome ha compiuto un passo rivoluzionario nel campo della ricerca sull’intelligenza artificiale creando quella che è stata battezzata come Mirror Dimension. Si tratta di una copia isolata del web, un vero e proprio internet falso che ospita migliaia di siti sintetici, tra cui finti negozi online, feed di social network e portali bancari. Questo ecosistema chiuso è stato progettato specificamente per permettere all’agente Auto Browse di navigare in un ambiente che simula perfettamente la rete reale, garantendo al contempo che nessuna richiesta informatica sfugga mai dai confini sicuri della sandbox. La notizia dimostra quanto sia diventato complesso testare i nuovi modelli linguistici senza comprometterne la sicurezza e l’affidabilità in vista di un rilascio pubblico.
Il problema della consapevolezza della valutazione
Una delle sfide più grandi nell’addestramento dei modelli avanzati è la consapevolezza della valutazione, una condizione in cui un’intelligenza artificiale si accorge di essere sottoposta a un test e, di conseguenza, altera il proprio comportamento per assecondare i ricercatori invece di agire in modo naturale. Per ingannare l’agente e fargli credere di trovarsi nel mondo reale, la barra degli indirizzi del browser mostra URL autentici e familiari, come il vero dominio di YouTube. Nel frattempo, in background, una versione di Chrome senza interfaccia grafica viene eseguita all’interno di una sandbox gVisor. A fare da ponte in questo intricato processo c’è un server proxy che intercetta le richieste e fornisce al modello il sito web falso al posto di quello reale, creando un’illusione perfetta e indistinguibile dal web autentico.
Aggirare i controlli di sicurezza con certificati TLS personalizzati
L’implementazione di un sistema di simulazione del genere porta con sé notevoli ostacoli tecnici, primo fra tutti la severa reazione del navigatore di fronte a siti web contraffatti. I moderni sistemi di sicurezza del browser sono progettati per bloccare immediatamente le connessioni quando rilevano una discrepanza tra l’indirizzo web richiesto e la firma digitale del server. Per impedire che l’ambiente di test segnali l’anomalia e smascheri lo scambio informatico, il proxy è stato programmato per coniare autonomamente dei certificati TLS fasulli, generandoli a partire da una propria autorità di certificazione root. In questo modo, l’agente artificiale rileva tutti i parametri di sicurezza standard, considera la connessione come crittografata e legittima, e rimane totalmente all’oscuro della messa in scena.
Generazione sintetica e automatizzata dei siti web
L’aspetto forse più affascinante di questo progetto ingegneristico è che la creazione di questo universo digitale non è affidata a laboriosi programmatori umani, bensì a un’altra schiera di intelligenze artificiali. Gli ingegneri di Google hanno implementato un sistema di generazione sintetica in cui diversi agenti collaborano incessantemente per costruire i siti fittizi necessari al collaudo. Un primo modello linguistico si occupa di redigere le specifiche tecniche, un secondo agente traduce queste direttive scrivendo il codice HTML e CSS necessario per l’infrastruttura visiva, mentre un terzo modello assume il ruolo di critico. Quest’ultimo ha il compito di ispezionare il layout finale e verificare l’usabilità degli elementi sfruttando gli strumenti di ispezione avanzati di DevTools, garantendo che ogni singola pagina della simulazione sia credibile, interattiva e funzionale.
Sicurezza e iniezioni di prompt nascoste
L’infrastruttura della finta rete internet non serve solo a far navigare il modello, ma soprattutto a testarne la vulnerabilità agli attacchi informatici esterni. All’interno di queste pagine sintetiche, gli sviluppatori nascondono intenzionalmente delle pericolose iniezioni di prompt, ovvero istruzioni malevole progettate per confondere l’intelligenza artificiale o costringerla a compiere azioni non previste o dannose. Queste trappole informatiche vengono strategicamente posizionate all’interno dei testi visibili, nascoste nei metadati delle immagini, celate nelle etichette ARIA utilizzate per l’accessibilità o perfino inserite all’interno delle risposte simulate degli strumenti. Per tracciare con precisione millimetrica l’esito di questi attacchi e capire se l’agente è stato effettivamente compromesso, gli identificativi del carico utile malevolo vengono accuratamente occultati all’interno di un header HTTP, permettendo ai ricercatori di monitorare il flusso senza destare sospetti.
Efficienza dei test e risultati ancora avvolti nel mistero
I risultati operativi di questa complessa infrastruttura virtuale sono impressionanti dal punto di vista del volume di lavoro processato. Questa innovativa catena di montaggio automatizzata garantisce una formidabile efficienza dei test, permettendo a ogni singolo ingegnere di eseguire oltre mille valutazioni al giorno. Secondo i dati emersi dalla notizia, si tratta di un ritmo operativo trenta volte superiore rispetto alle tradizionali e lente procedure di verifica manuale. Tuttavia, un alone di mistero avvolge ancora le reali capacità dell’intelligenza artificiale sotto esame. Fino a questo momento, infatti, l’azienda di Mountain View non ha reso pubblico alcun tasso di superamento ufficiale riguardo a questi esperimenti. Di conseguenza, la vera resilienza dell’agente contro le manipolazioni e il suo reale grado di preparazione per affrontare in totale sicurezza il web aperto restano, per ora, un’incognita a cui solo Google può rispondere.
 Vuoi ricevere le notifiche sulle nostre notizie più importanti?
